这道题在问什么
中心极限定理(CLT)说:标准化的和 的分布越来越接近标准正态,所以 超过一个大数 的概率大约是 可以任意小。而样本均值的误差正好是
一个确定地趋于 0 的因子乘一个很少很大的量,于是误差依概率趋于 0,这就是弱大数定律(WLLN)。证明的关键一步:固定 等 大到 把「误差 装进「里,先让 再让
- 考点:依分布收敛与中心极限定理的陈述;弱大数定律的陈述;把一个事件改写成标准化变量的事件;「先 后 的两次取极限;上极限的用法。
- 要用的讲义结论:依概率收敛(第 3 讲 第 14 页);样本均值的方差 (第 3 讲 第 37 页);Chebyshev 不等式(第 2 讲 第 29 页);累积分布函数(第 2 讲 第 8 页);独立性(第 4 讲 第 16 页–第 18 页)。
- 讲义没有讲过、这里作为已知结论使用的:依分布收敛、中心极限定理、弱/强大数定律(见「先补基础」)。
- 与其他题的关系:第 3 题 的「依概率有界 × 依概率趋于 0 = 依概率趋于 0」正是本题的骨架;第 7 题、第 9 题 还会用到 CLT 和 Slutsky 定理;作业 1 第 3 题 说明均值无穷时 没有有限极限,第 5 题 进一步研究均值无穷时 的增长。
先补基础
设 独立同分布(i.i.d.),
- 部分和 样本均值
- 均值:期望是线性的,
- 方差:独立(只要两两不相关就够)时方差可加,标准差 (第 3 讲 第 37 页)。
- 标准化:它的均值为 0、方差为 1。读作「 星」。
- 例:公平硬币,正面记 1、反面记 0:掷 100 次, 的均值 50、标准差 5,
- 标准正态的密度 分布函数
- 处处连续,严格递增,(密度关于 0 对称),(
- 若 则 常用数值: 时 时 时 时
- 定义(Durrett《Probability: Theory and Examples》第 5 版第 3.2 节):设 若对 的每个连续点 都有 就说 依分布收敛(converge in distribution,也叫弱收敛)到 记作
- 它只看分布:不要求 和 在同一个概率空间上,也不说 与 接近。例: 与 同分布,所以 但 一点也不接近。
- 为什么只要求连续点:直觉上应当收敛,可 在 的间断点 0 处不收敛;在其他点都收敛。定义把间断点排除,这个例子才算收敛。
- 与依概率收敛的关系:依概率收敛 ⇒ 依分布收敛;反过来一般不对(上面 的例子);但依分布收敛到常数 ⇒ 依概率收敛到这个常数。
- 本题要用的:极限是 时 处处连续,所以 就是「对每个实数
定理(Durrett 定理 3.4.1):设 i.i.d.,则
- 意思:不管 是什么分布(硬币、骰子、指数……),只要方差有限, 偏离 的量在 的尺度上看近似正态。
- 例:硬币掷 100 次,(精确值 差别来自离散性)。
- 条件:需要方差有限。方差无穷时(如例 3 的 Pareto 分布), 的标准化不再给出正态极限。
- 弱大数定律(WLLN): i.i.d.,则 即对每个 (Durrett 定理 2.2.14)。只假设方差有限的版本(Durrett 定理 2.2.3,「 弱大数定律」)用 Chebyshev 一行证明:
- 强大数定律(SLLN): 时 几乎必然(Durrett 定理 2.4.1)。作业 1 第 3 题 说明条件 不能去掉。
- 「弱」「强」:指收敛方式。几乎必然收敛 ⇒ 依概率收敛(第 3 讲 第 14 页),所以强大数定律蕴含弱大数定律。
若一个数列 (这里 满足:对每个 而 (则 理由: 是一个不依赖 的数,它不超过每个 所以不超过它们的下确界 0;又
为什么用 而不是 :我们还不知道 存在(这正是要证的), 却总存在。
题目与原解答
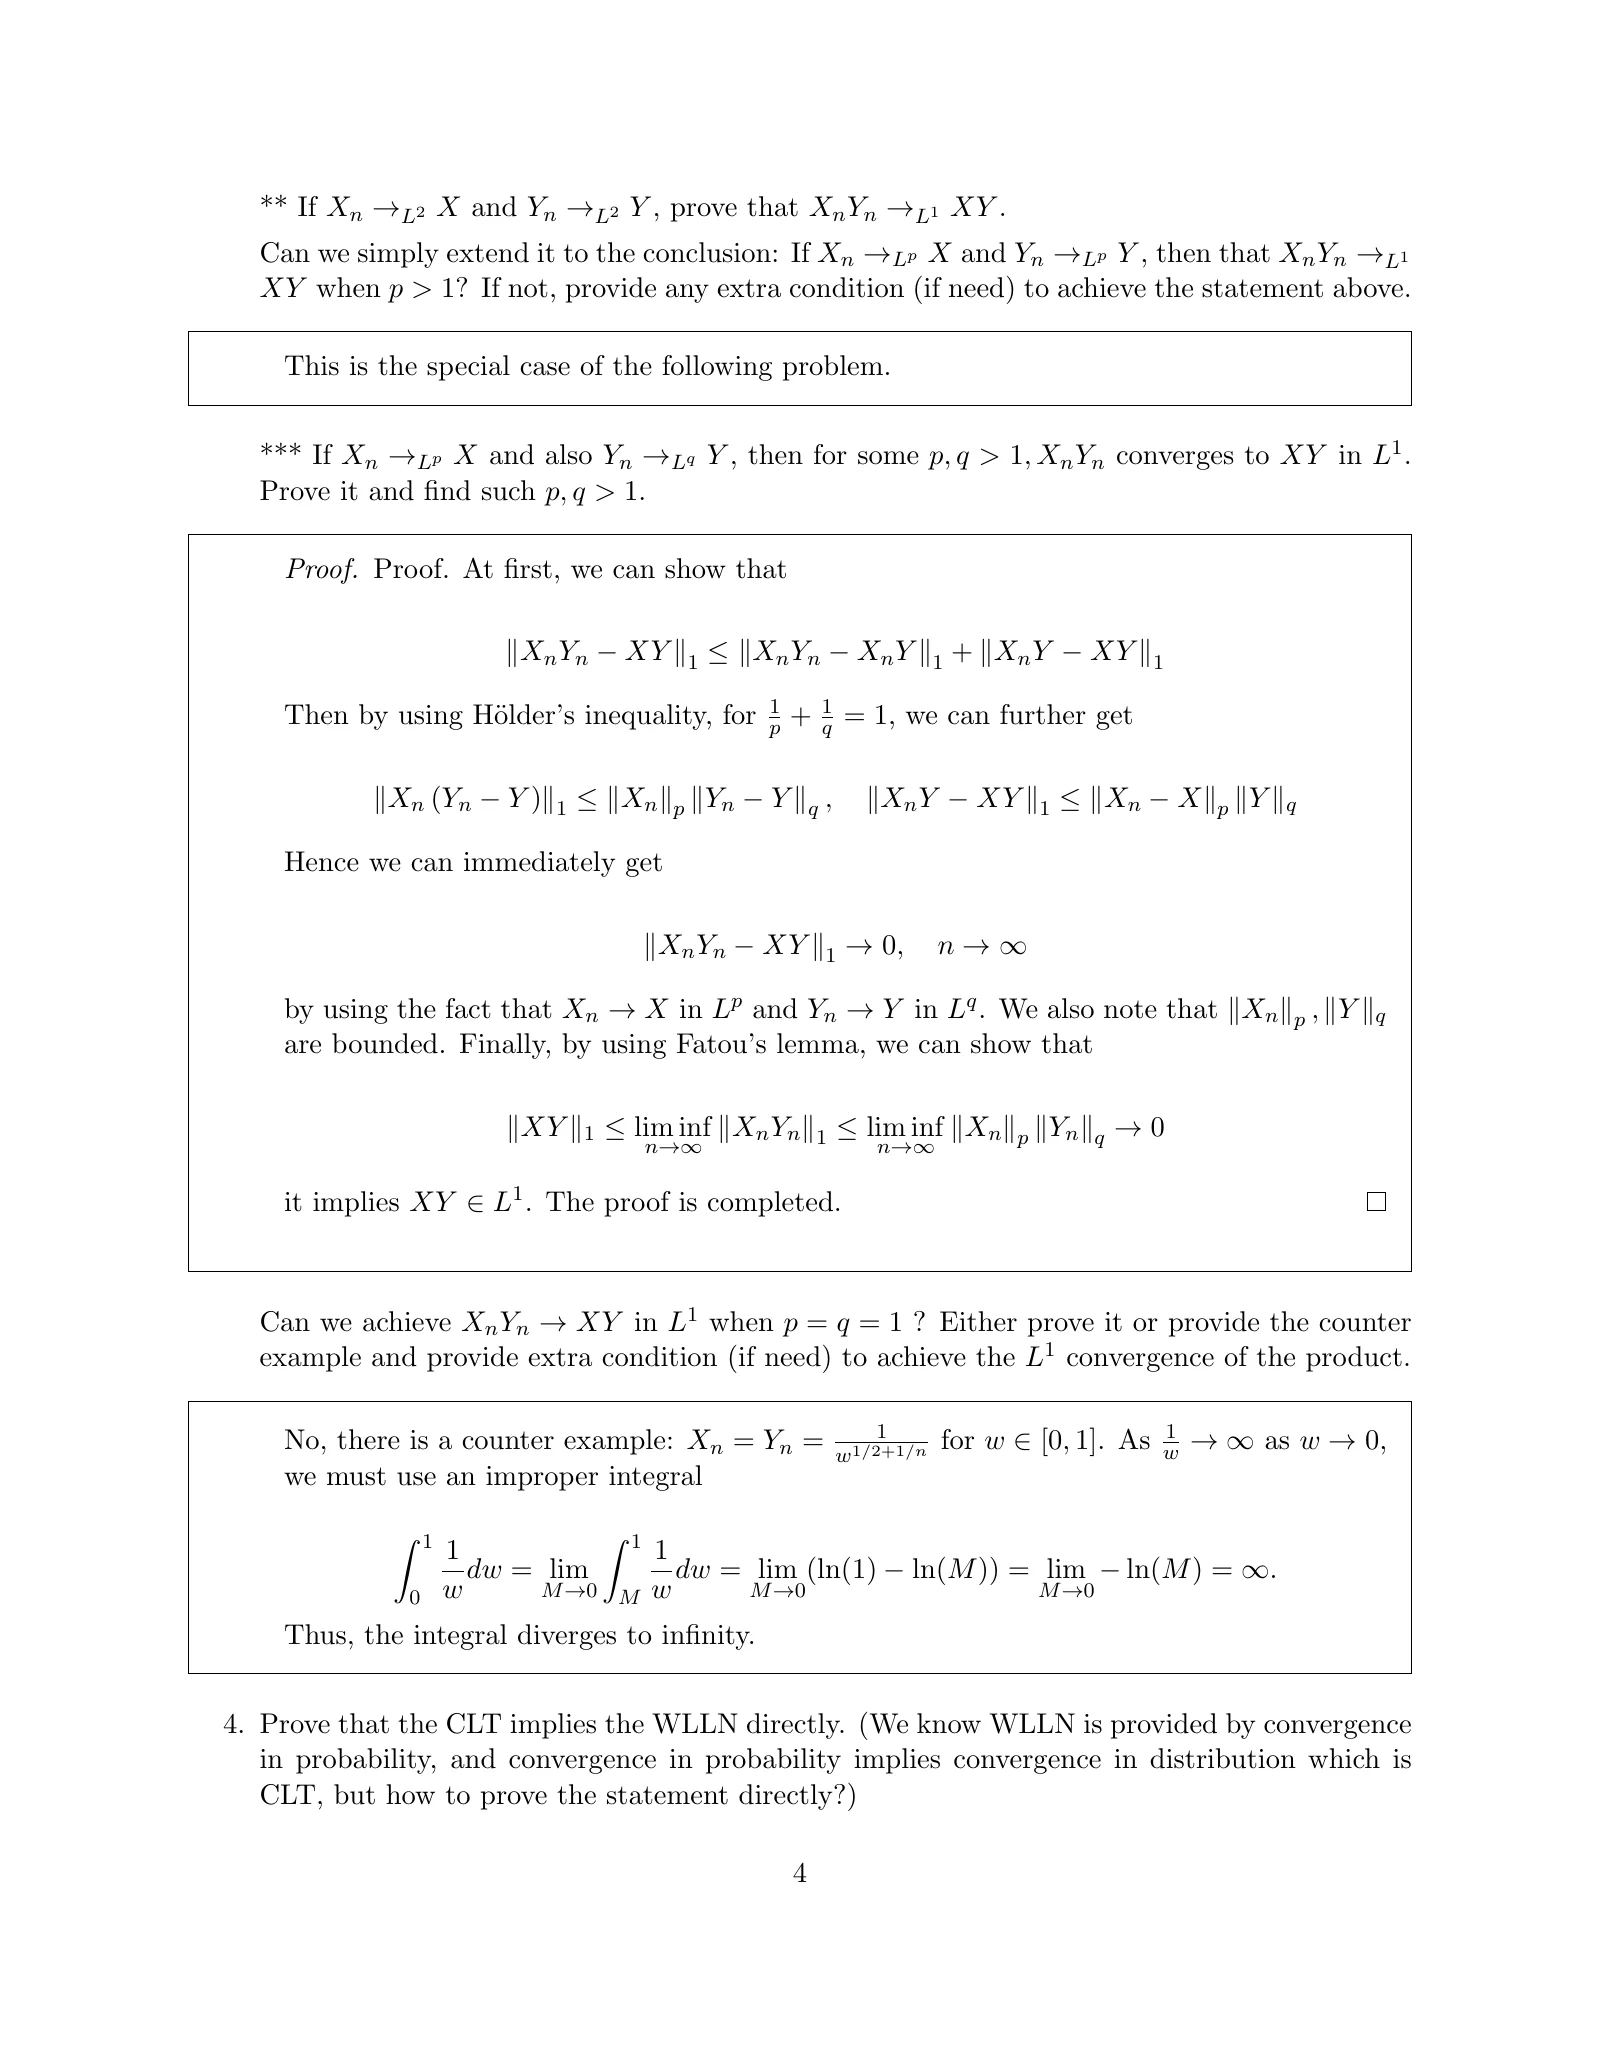
4. Prove that the CLT implies the WLLN directly. (We know WLLN is provided by convergence in probability, and convergence in probability implies convergence in distribution which is CLT, but how to prove the statement directly?)
4. 直接证明:中心极限定理(CLT)蕴含弱大数定律(WLLN)。(我们知道 WLLN 是依概率收敛的结论;依概率收敛蕴含依分布收敛,而 CLT 是依分布收敛的结论。但怎样直接证明这个命题?)
题面说明:
- 题目没有写设定,应补上: i.i.d.,(这是 CLT 的条件),要证
- 括号里的话容易误读。「依概率收敛 ⇒ 依分布收敛」本身是对的,但它的方向是从 WLLN 的收敛方式走向 CLT 的收敛方式,不能用来从 CLT 推出 WLLN;而且两个定理讲的是不同的量:WLLN 讲 CLT 讲放大了 倍的 所以需要一个「直接」的论证,把两者的尺度联系起来。
- 「CLT implies WLLN」是在 CLT 的条件(方差有限)下说的。WLLN 本身只要 这个更一般的情形 CLT 推不出来(例 3)。
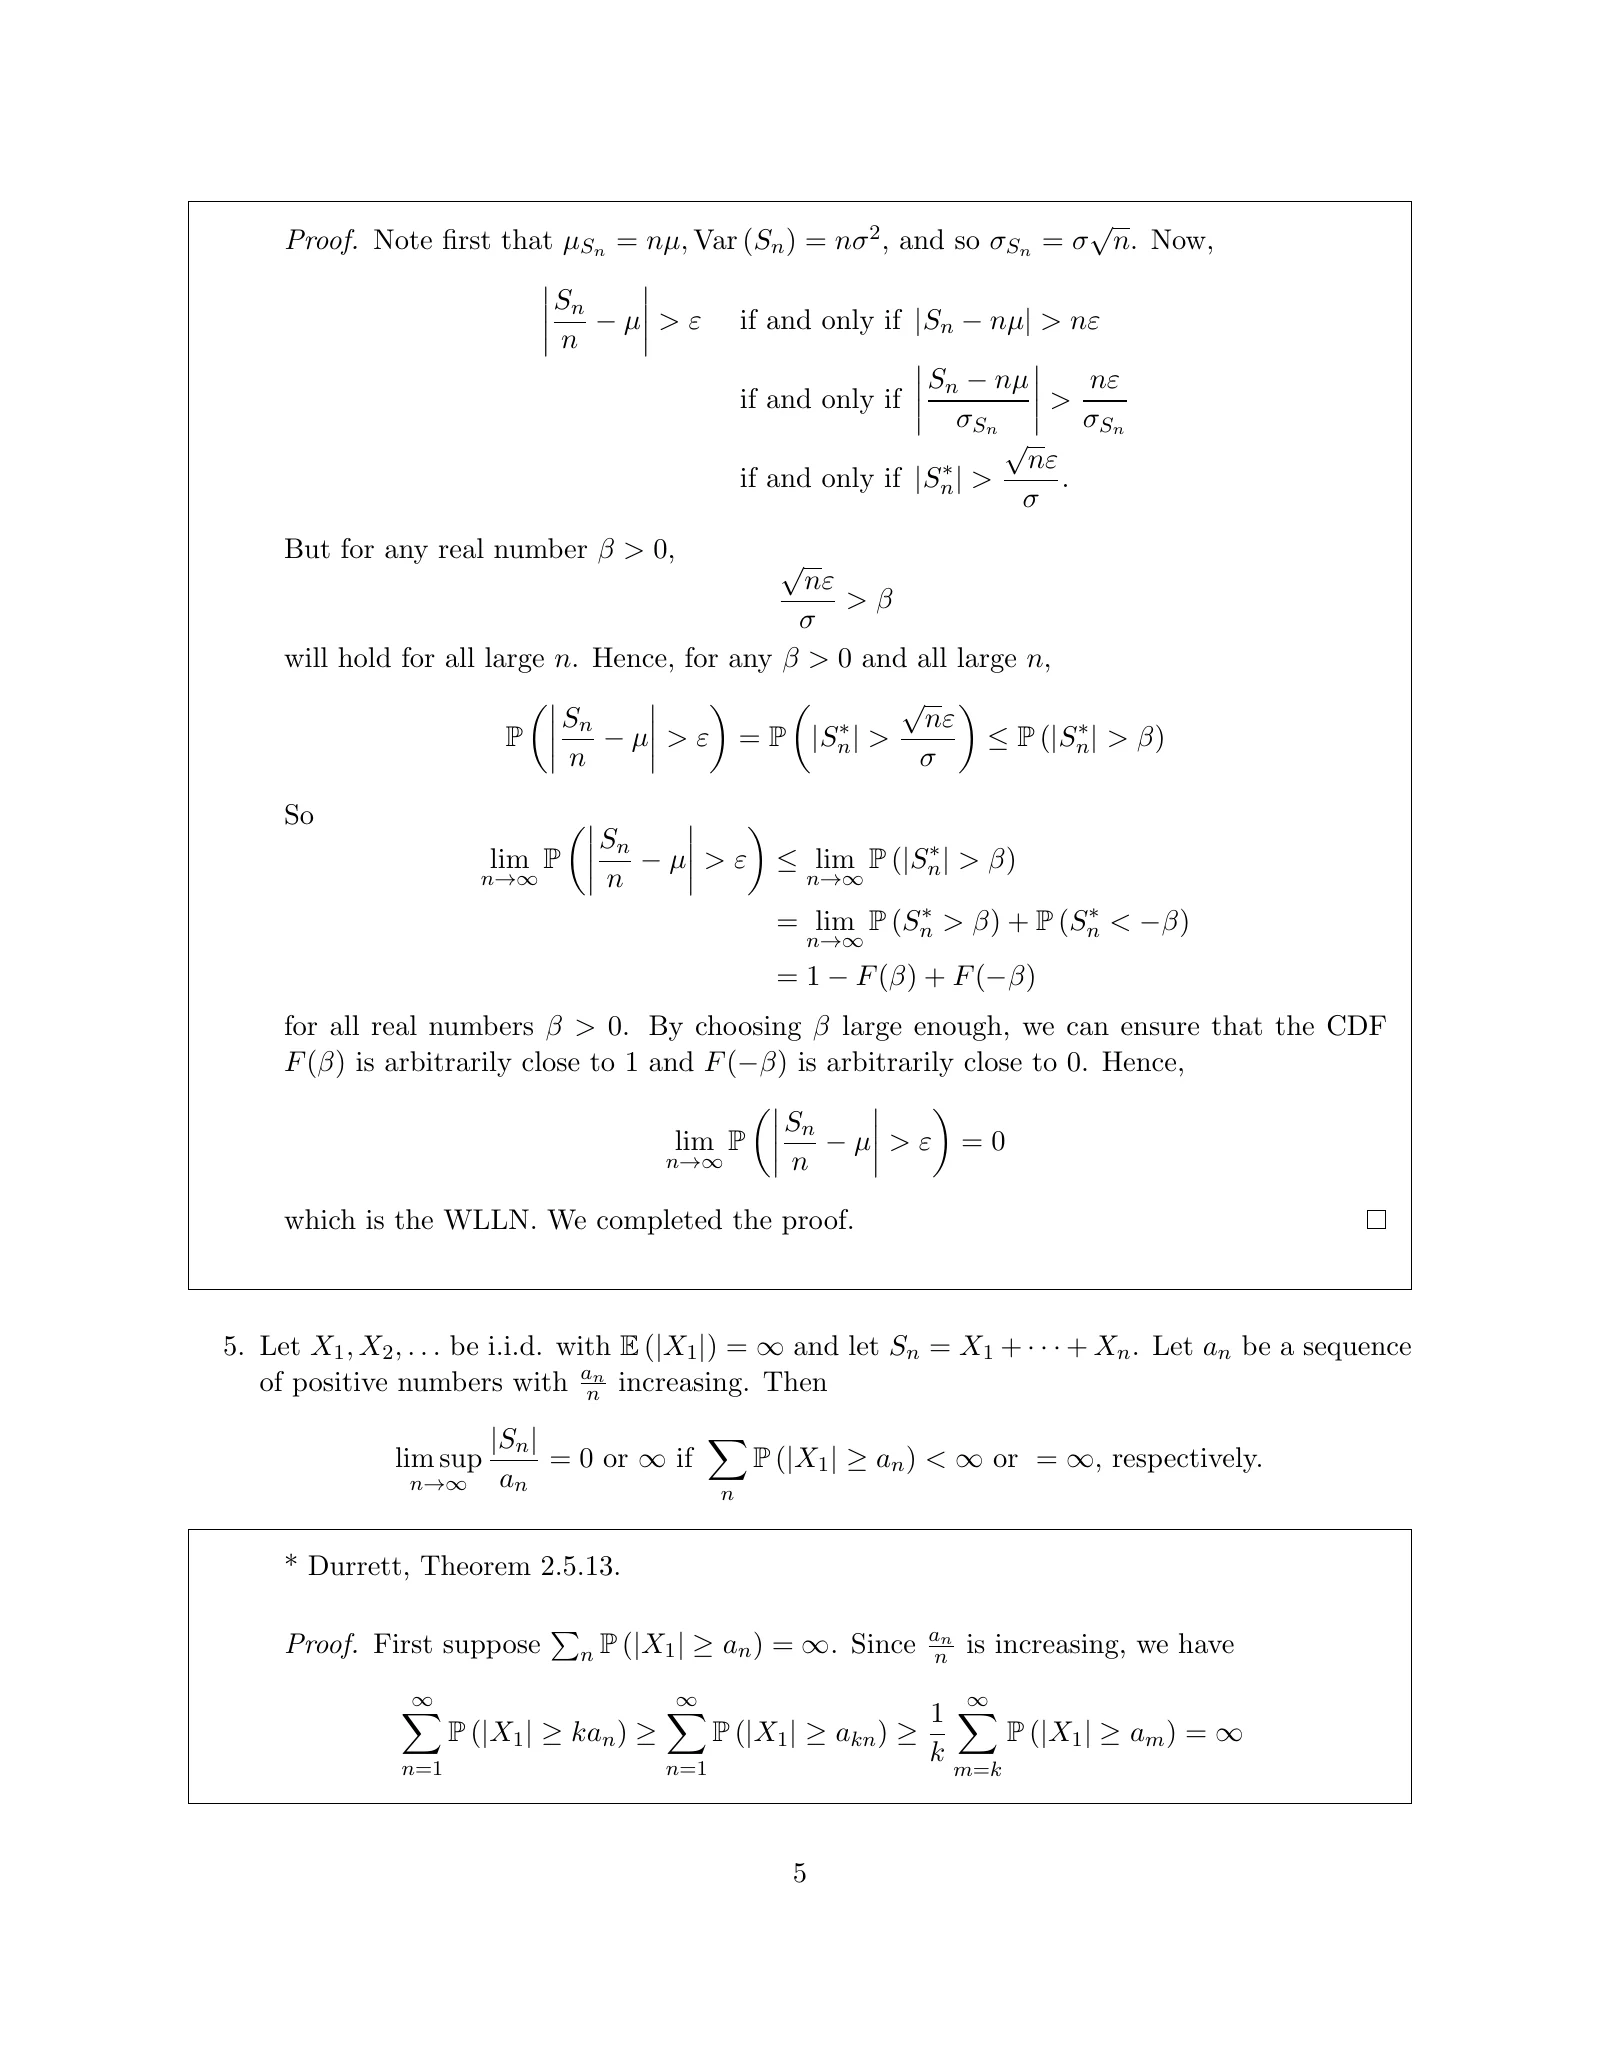
原解答的思路(左栏):
- 把事件 等价地改写成
- 任取 足够大时 所以概率
- 由 CLT, 取大,它任意小,所以
思路完全正确,有几处记号没定义、 应为 严格不等号的极限没有说明,见「原解答逐行对照」。
思路:怎么想到的
- 两个定理在不同的尺度上:WLLN 关心误差 是否小于固定的 CLT 告诉我们误差的典型大小是 并且误差除以 后近似
- 固定的门槛在放大镜下越来越远:在 CLT 的尺度上看,门槛 变成 标准正态超过一个很大的数的概率很小,所以误差超过 的概率很小。
- 为什么要引入固定的 :CLT 只保证「对每个固定的 门槛 却随 变化,不能直接代进去。办法是用一个固定的 放在中间:门槛迟早超过 事件变小,概率变小;对固定的 才能用 CLT。
完整解答
设 i.i.d.,假设中心极限定理成立:对每个 其中 则对每个
改写成标准化变量的事件;固定 大时把它装进 对固定的 用 CLT 求出上极限的界 最后令
第 1 步(改写事件):固定 因为 不等式两边同乘或同除正数不改变方向:
所以
第 2 步(固定 把事件放大):任取 当 时,此时若 则 即事件包含 由概率的单调性,
第 3 步(对固定的 用 CLT): 是两个不相交事件 的并,所以
- 第一项:(CLT 在 处)。
- 第二项:所以 (CLT 在 处),从而
合起来,并用
第 4 步(先 后 :由第 2、3 步(上极限只看 的项,前面有限项不影响),
左边不依赖 右边在 时趋于 由「先补基础」最后一张卡片, 任取,所以
补充: 的情形。此时 几乎必然, 几乎必然,结论直接成立;CLT 只在 时才有意义(要除以
第 3 步其实证明了 依概率有界: 大时任意小。第 3 题 的「拓展延伸」说明:依概率有界的量乘一个趋于 0 的因子,依概率趋于 0。本题就是这条规则加上「依分布收敛的序列依概率有界」。
原解答逐行对照
第 1 行:「and so 正确,前提是 独立(或两两不相关)且方差有限;方差可加性正是用在这里。
第 2–4 行:三个「if and only if」把 改写成 正确,即完整解答第 1 步;每一步都是两边乘或除同一个正数。
第 5–6 行:「for any real number , will hold for all large 于是 正确,「all large 具体是
- 没有定义,应为 没有定义,应为标准正态分布函数
- 没有写出假设: i.i.d., 用于除法, 是 CLT 的条件。
- 没有写出 CLT 的陈述,而第 7 行正是在用它: 对每个
第 7–9 行:
- 左边的 还不知道存在,它的存在正是要证明的结论。应写 最后由 得到极限存在且为 0。
- 需要理由:CLT 给的是 的极限,这里是严格的 做法一:只要上界,(完整解答第 3 步)。做法二:利用 连续,对任意 两边的极限 在 时相同。
- 括号: 应写成 两项都在取极限。
第 10–11 行:「By choosing large enough, we can ensure that the CDF is arbitrarily close to 1 and is arbitrarily close to 0. Hence 正确,就是完整解答第 4 步:左边不依赖 右边可以任意小。应补一句「左边与 无关」,这是能令 的原因。
例子与数值验证
公平硬币,取 精确概率 用二项分布算;CLT 近似是 Chebyshev 上界是 用 Python 计算:
| 精确值 | CLT 近似 | Chebyshev 上界 | |
|---|---|---|---|
| 100 | 0.271 | 0.317 | 1 |
| 400 | 0.0402 | 0.0455 | 0.25 |
| 1000 | 0.00139 | 0.00157 | 0.1 |
| 2500 | 0.04 |
三列都趋于 0(WLLN)。CLT 近似和精确值同一个量级,Chebyshev 上界保守得多:它只按 衰减,真实概率衰减得快得多。注意门槛 随 移动,CLT 本身并不保证这时近似的相对误差小,表中的吻合是算出来观察到的;误差概率精确的指数衰减速度属于「大偏差理论」,不在本课范围。
服从 Gamma 分布,精确概率可以直接算。取 (Python 计算):
| 精确值 | CLT 近似 | Chebyshev | |
|---|---|---|---|
| 100 | 0.3165 | 0.3173 | 1 |
| 400 | 0.0454 | 0.0455 | 0.25 |
| 1000 | 0.00161 | 0.00157 | 0.1 |
连续分布没有离散带来的偏差,CLT 近似非常准。
取 (即 在 上均匀。但 WLLN(Durrett 定理 2.2.14)仍然成立,CLT 的条件却不满足。用 Python 模拟(固定随机种子; 各重复 20000 次, 分别重复 5000、2000 次):
| 的比例 | 0.69 | 0.35 | 0.061 | 0.021 |
| 的四分位距 | 7.0 | 11.3 | 17.8 | 27.0 |
第一行趋于 0:WLLN 成立。第二行不断变大: 没有稳定的分布, 的标准化「压不住」它(理论上 是 的量级)。所以本题的论证只在方差有限时可用,CLT 推出的 WLLN 比真正的 WLLN 弱。
i.i.d. 标准 Cauchy。一个已知事实: 仍然服从标准 Cauchy 分布(对每个 所以 对所有 都一样,不趋于 0:样本均值根本不稳定。这里 既没有 WLLN,也没有 CLT。
拓展延伸
Slutsky 定理:另一条(间接的)路线
Slutsky 定理(这里作为已知结论使用,Durrett 第 5 版第 3.2 节习题 3.2.13、3.2.14):若 (常数),则
用它:(常数序列当然依概率收敛),所以 再用「依分布收敛到常数 ⇒ 依概率收敛」:
因为常数 0 的分布函数在 处连续,取值分别为 1 和 0。题目说的「直接证明」就是不经过这两步,而原解答的论证正是把 Slutsky 在这个特例里的证明展开写了出来。
CLT 比 WLLN 多说了什么:误差的尺度与形状
WLLN 只说误差趋于 0;CLT 还说误差大约是 乘一个标准正态。统计里的 95% 置信区间 就来自 要让误差减半,样本量要变成 4 倍。精确到「近似有多好」的结论是 Berry–Esseen 定理:若 则 是一个绝对常数(不超过 0.48)。
能不能把移动的门槛直接代进 CLT?
如果 CLT 的收敛对 一致,就可以直接写 事实上这是对的:Pólya 定理说,依分布收敛到一个连续的分布函数时,收敛自动对 一致(Durrett 第 3.2 节习题)。但这需要额外的定理;原解答引入固定的 只用逐点的 CLT 就完成了证明,更初等。
从 WLLN 到 SLLN、从 i.i.d. 到相依
常见疑问与易错点
答:CLT 是对每个固定的 说 门槛 随 变化,不是固定的 「也没有意义。必须先用固定的 把事件放大(第 2 步),对 用 CLT,最后再让 直接代入需要一致收敛(Pólya 定理),那是额外的结论。
答:不能。WLLN 推出 (依分布收敛到常数),这只说明误差趋于 0,对误差在 尺度上的形状一无所知。CLT 是更精细的结论,例 3 就是 WLLN 成立、CLT 不成立的例子。题目括号里的话正是在提醒:两者讲的是不同尺度上的量。
答:两处:一是 有限才能写出 和 二是 CLT 本身需要方差有限。所以「CLT ⇒ WLLN」只在方差有限时有意义;而此时 Chebyshev 一行就能证明 WLLN。本题的价值在于理解两个定理的关系,而不是得到一个新的 WLLN。
答:若 且 则 严格不等号传递过来,得到 所以只要 不需要严格大于。
小结与自测
- 设定:i.i.d.,CLT:WLLN:
- 关键恒等式:门槛在 CLT 的尺度下趋于无穷。
- 证明:固定 时概率 对固定 用 CLT 得 令
- 本质:误差 (依概率有界的量)。CLT 只在方差有限时可用,所以它推出的 WLLN 比 Khinchine 的 WLLN(只要 弱。
- 原解答:思路正确;假设未交代;左边应写 的极限要用 连续或改成上界。
1. 设 至少多大时,第 2 步的包含关系 一定成立?
点开看答案
需要 即 此时 的界是
2. 判断:若 (依分布收敛到常数 0),则
点开看答案
正确。常数 0 的分布函数在 处连续,取值 1 和 0,所以 于是 注意极限不是常数时,依分布收敛推不出依概率收敛( 与 的例子)。
3. 简答: i.i.d.,(本题的方法能证明 吗?结论本身对吗?
点开看答案
不能,因为 CLT 的条件不满足, 都写不出来。但结论是对的:由只要求一阶矩的 WLLN(Durrett 定理 2.2.14)甚至 SLLN,例 3 的模拟显示偏离 0.3 以上的比例从 0.69 降到 0.021。
| 中文 | English | 白话解释 |
|---|---|---|
| 中心极限定理 | central limit theorem (CLT) | 独立同分布、方差 σ² 有限时,(Sₙ − nμ)/(σ√n) 依分布收敛到标准正态分布:大量独立小误差之和近似正态。 |
| 分布 | law / distribution | X 把概率「推」到取值空间上得到的测度:L(X)(B) = P(X ∈ B)。 |
| 弱大数定律 | weak law of large numbers (WLLN) | 样本均值依概率收敛到真实均值:对每个 ε > 0,P(|Sₙ/n − μ| > ε) → 0。方差有限时可由 Chebyshev 不等式直接推出。 |
| 依分布收敛 | convergence in distribution | 在极限分布函数 F 的每个连续点 x 上,P(Xₙ ≤ x) → F(x)。它只比较分布,不要求 Xₙ 本身靠近 X。 |
| 事件 | event | 样本空间的(允许谈概率的)子集;实现的 ω 落在里面,就说事件发生。 |
| 上极限 | limit superior (lim sup) | 数列「尾部的最大可能值」的极限;对集合则表示「发生无穷多次」。 |
| 依概率收敛 | convergence in probability | 对每个 ε > 0,P(|Xₙ − X| > ε) → 0;比几乎必然收敛弱。 |
| 方差 | variance | Var X = E[(X − E X)²],衡量随机变量围绕均值的波动大小。 |
| Chebyshev 不等式 | Chebyshev's inequality | P(|X − μ| ≥ t) ≤ σ² / t²:方差控制偏离均值的概率。 |
| 累积分布函数 | cumulative distribution function (CDF) | F(x) = P(X ≤ x),单调不减、右连续,完全决定分布。 |
| 独立 | independence | 任意有限个事件同时发生的概率等于各自概率的乘积。 |
| 强大数定律 | strong law of large numbers (SLLN) | 独立同分布且 E|X₁| < ∞ 时,样本均值 Sₙ/n 几乎必然收敛到 E X₁。 |
| 依概率有界 | bounded in probability (tight) | 一列随机变量不会以不可忽略的概率跑到无穷远:sup_n P(|Xₙ| > λ) → 0(λ → ∞)。依概率收敛的序列一定依概率有界。 |
| Slutsky 定理 | Slutsky's theorem | Xₙ 依分布收敛到 X,Yₙ 依概率收敛到常数 c,则 Xₙ + Yₙ 依分布收敛到 X + c,XₙYₙ 依分布收敛到 cX。 |
| 独立同分布 | independent and identically distributed (i.i.d.) | 一列随机变量相互独立,并且分布都相同,例如反复独立地掷同一颗骰子。 |
| 部分和 | partial sum | 级数 a₁ + a₂ + … 的前 n 项之和 Sₙ = a₁ + … + aₙ;级数的值就是 Sₙ 在 n → ∞ 时的极限。 |
| 期望 | expectation | 随机变量对概率测度的积分 E[X] = ∫ X dP,也就是「加权平均」。 |
| 函数 | function / map | f: A → B 给 A 中每个元素指定 B 中唯一一个元素。 |
| 概率空间 | probability space | 三元组 (Ω, 𝓕, P):样本空间、事件的 σ-代数、概率测度。 |
| 几乎必然收敛 | almost sure convergence | 除了概率为 0 的结局以外,Xₙ(ω) 都收敛到 X(ω)。 |
| 下确界 | infimum (inf) | 最大的下界。例如 (0,1] 没有最小值,但下确界是 0。 |
| 标准正态分布 | standard normal distribution | 均值 0、方差 1 的正态分布 N(0, 1),密度 exp(−x²/2)/√(2π),分布函数记作 Φ。 |
| 上界 | upper bound | 数集 A 的上界是一个数 M,A 里每个数都 ≤ M。例如 2 和 5 都是 [0,1] 的上界;所有上界中最小的那个叫上确界。 |
| 区间 | interval | 数轴上的一段,[a,b] 包含端点,(a,b) 不包含端点。 |
| 一致收敛 | uniform convergence | 所有点上的最大差距 supₓ |fₙ(x) − f(x)| → 0。比逐点收敛强:不允许某些点收敛得特别慢。 |
| 阶矩 | moment | E[|X|ᵖ] 叫 p 阶(绝对)矩;它有限与否反映尾部有多「重」。 |