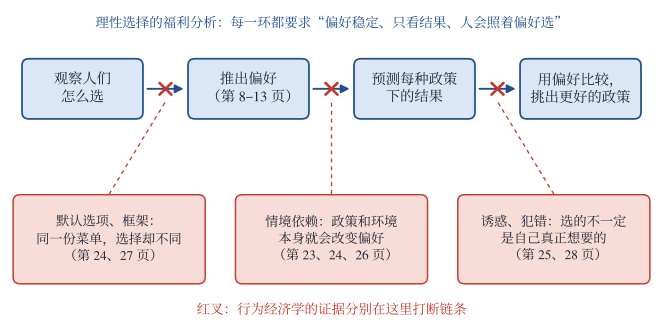
这一页在讲什么
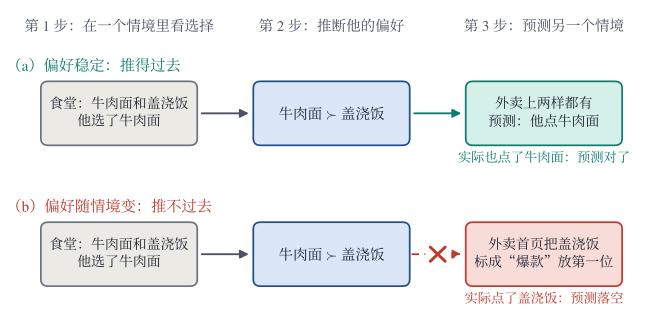
第 23–27 页列出了理性选择模型的种种不符。这一页回答:经济学家怎么办?答案是修改模型,大致有四个方向:让偏好依赖情境;把诱惑、提示、框架写进去;允许人只部分优化、会犯错;用学习规则和习惯来描述行为。最后一句话是关键:模型越像真人,就越难处理、预测也越不明确,这是一个取舍。
逐句读懂
- 意思:允许偏好依赖于情境。
- 做法:不再只写一个偏好 ⪰,而是写“在情境 A 下的偏好” ⪰A,并规定它怎样随情境变化。只说“会变”没用,要说清楚怎么变,模型才能预测。下面的“参照点模型”是一个小例子。
- 读法:incorporate 是“纳入、写进去”;cue 是“提示、线索”。
- 意思:把诱惑、提示和框架纳入模型。下面的“诱惑与自控模型”是一个例子。
- 意思:有限理性(第 25 页)的模型:人只做部分的优化,并且会犯错。
- 例子:只比较菜单里最显眼的几样;或者每个选项被选中的概率随它的好坏而变,好的更常被选,但差的也有一定机会被选中(选错)。
- 读法:adaptive 是“适应性的”,即根据经验调整;habit formation 是 习惯形成。
- 意思:学习模型:人按适应性规则行动(第 25 页的通勤例子),过去的消费会形成习惯,改变今天的偏好。
- 读法:realism 是“现实性”;tractability 是 可处理性,即模型好不好算、好不好分析;predictive power 是 预测力,即能不能给出明确的、可检验的预测。
- 意思:这里有一个取舍:现实性对可处理性和预测力。本页最后用一张图细讲。
偏好依赖情境
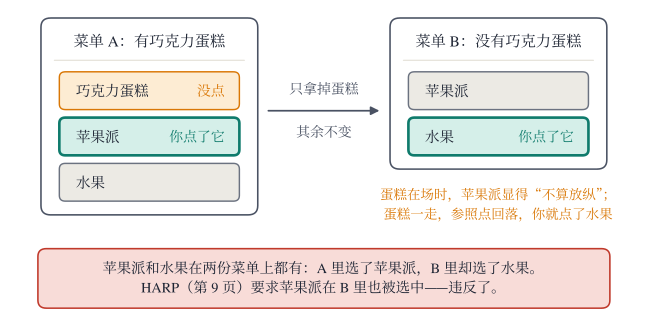
用一个小模型重现第 24 页的甜品菜单。给每样甜品两个分数:
| 甜品 | 好吃程度 t | 放纵程度 g |
|---|
| 巧克力蛋糕 k | 10 | 10 |
| 苹果派 p | 7 | 5 |
| 水果 f | 4 | 0 |
假设你心里的参照点是“这份菜单上的平均放纵程度”,记作 gˉ(A)。点的东西比这个平均更放纵,你就会内疚,每高出 1 分扣 λ 分。于是在菜单 A 里,甜品 x 给你的满足是
U(x∣A)=t(x)−λ⋅max{0, g(x)−gˉ(A)}.
取 λ=2,逐个菜单算:
| 菜单 A | gˉ(A) | 蛋糕 | 苹果派 | 水果 | 选中 |
|---|
| {k,p,f} | 5 | 10−2×5=0 | 7−0=7 | 4 | 苹果派 |
| {p,f} | 2.5 | — | 7−2×2.5=2 | 4 | 水果 |
| {k,p} | 7.5 | 10−2×2.5=5 | 7 | — | 苹果派 |
| {k,f} | 5 | 10−2×5=0 | — | 4 | 水果 |
四个菜单的选择和第 24 页完全一样,包括那对违反 HARP 的选择。原因是:蛋糕在场时抬高了参照点,苹果派“不再显得放纵”;蛋糕一走,参照点降下来,苹果派就显得太放纵了。
这个模型有了预测力:它说明了偏好怎样随菜单变,还能推出新的结论。比如,如果你不太容易内疚(λ=1),菜单 {p,f} 里苹果派得 7−2.5=4.5,比水果的 4 分高,你就会选苹果派,反转消失。所以模型预测:越容易内疚的人,越容易出现这种反转,这是可以拿数据检验的。
真实研究里的同类模型,比如 Tversky 和 Simonson(1993)的情境依赖偏好、Kőszegi 和 Rabin(2006)的 参照点 依赖偏好,思路相同,只是更一般。
诱惑与自控
Gul 和 Pesendorfer(2001,《Econometrica》)换了一个角度:让人对菜单本身有偏好。他们的想法是:面对诱惑时,要么屈服,要么忍住,忍住是要花力气的。每样东西有两个分数:
- u(x):冷静时你觉得它有多好(长远利益);
- v(x):它当下有多诱人(诱惑程度)。
面对菜单 A,你的满足是
U(A)=x∈Amax[u(x)+v(x)]−y∈Amaxv(y).
第一项是你最终的选择(在长远利益和诱惑之间折中);第二项减去的是菜单上最诱人那样东西的诱惑,表示“看着它却不能要”的难受。
取一个数字例子:水果 u=6、v=1;蛋糕 u=2、v=6。
- 只有水果的菜单:U({f})=(6+1)−1=6。
- 水果和蛋糕都有:u+v 中蛋糕是 8、水果是 7,你会选蛋糕;U({f,k})=8−6=2。
U({f})=6>U({f,k})=2:你宁可菜单上少一样东西。在标准理性模型里,多一个选项永远不会更差(不想要可以不选),这里却严格更差。这就解释了 承诺手段:事先把诱惑拿掉。比如期末复习时用“专注森林”一类的软件把手机锁起来,宿舍里不囤零食,提前交一年的健身卡钱逼自己去。这些都是 自我控制 问题的现实对策。
另一个著名的方向是 Laibson(1997)的“现时偏向”:人总是格外看重“现在”,今天想“明天开始学习”,到了明天又想“明天再说”。它在研究“今天花还是以后花”这类跨期选择时特别重要。
会犯错,会学习
- 部分优化:人只在一部分选项里比较(比如只看外卖首页的前 10 家店),或者只考虑价格、不看评分。模型要说清楚“只看哪些”。
- 犯错:给每个选项一个被选中的概率,越好的越可能被选,但不是百分之百。这样一来,偶尔的“选错”也在模型的预测之内。
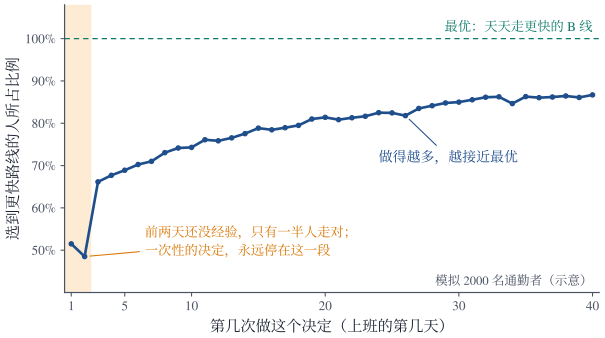
- 学习规则:Erev 和 Roth(1998)用“强化学习”描述实验中人们怎么玩博弈:过去带来好结果的做法,以后更常用。第 25 页的通勤模拟就是这一类。
- 习惯形成:你今天的偏好取决于你过去消费了多少。喝惯了全糖奶茶,突然改成半糖会觉得没味道;可坚持喝一个月半糖,再喝全糖反而嫌太甜。模型里写成“今天的满足取决于今天的消费和过去消费的差距”。
取舍:现实与可用
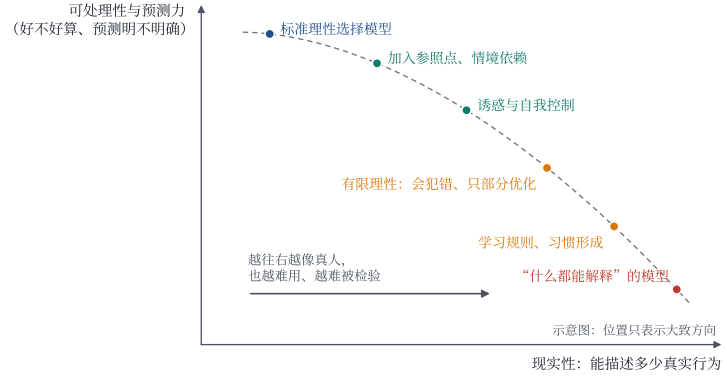 图 9现实性和可处理性、预测力之间的取舍(示意图,位置只表示大致方向)。标准理性模型最简单、预测最明确;越往右,越能描述真实行为,也越难计算、越难被检验。
可以拿地铁线路图打个比方。真实的地铁线路弯弯曲曲,站距有长有短;线路图把它画成横平竖直的直线,距离也不准,可正因为简单,你一眼就知道怎么换乘。如果线路图画得和卫星地图一样“真实”,反而没法用了。
经济模型也是这样:
- 标准理性模型在左上角:假设少,好算,预测明确(第 18 页说的“加限制才有预测”)。
- 每加一种行为因素(参照点、诱惑、犯错、学习),模型就能解释更多真实现象,但要多估计几个参数,结论也常常变成“取决于参数”。
- 最右下角是“什么都能解释”的模型:不管观察到什么都能说得通,也就什么都预测不了(第 10 页)。
好的行为模型,是用尽量少的新假设,解释一类重要的偏离,并且给出可以被推翻的新预测,就像上面的参照点模型预测“越容易内疚的人越容易反转”。
常见困惑
这一页的要点
自测
只记在你自己的浏览器里,左侧目录会打勾